
一句话: 一组 Listen & Repeat 走的是一条可预判的阶梯——每一句都比前一句长,从 6.6 词一路到 12.8 词。但让最后一句变难的并不是长度。复合句占比在前四句几乎贴着地面,到最后陡然立起:第 1 句我们没有任何一组用从句,第 7 句五组里有四组用了。长度和复杂度是两个独立的旋钮,而收尾时只有其中一个被拧动。
搜”托福口语题”,你现在多半还是会落到一份 180 道题的 PDF 上。它曾经是份好资料,如今只是件陈列品:2026 改革把旧的口语部分整个换掉了,那 180 道题一道都不会再出现。
真正有用的问题不是你”会遇到哪几道”——你不会遇到任何一道特定的题,也没人能把清单给你。有用的是:这些题长什么样。这件事是可知的、稳定的,也才是你真能拿来准备的东西。
所以我们把自己的题量了一遍。下面所有数字都来自我们题库里每一句 Listen & Repeat 句子和每一道面试题,取数日期 2026-09-17。每个口径都写在原处,你可以顺着核,不必只信我们的结论。如果你要的是格式层面的事实——几道题、多长、有没有准备时间——那些我们放在2026 托福改革了什么里。
七句话在爬一条阶梯
一组 Listen & Repeat 是七句话,而这七句不是同一件东西的七个样本。它们按长度分三档:两句短,三句中,两句长。
这个结构不是我们发明的,也不是什么秘密。公开资料里被引用最多的 Listen & Repeat 指南之一来自 TOEFL Resources,他们自己的原话是:
The sentences gradually get longer. There are two “short” sentences, three “medium” sentences and two “long” sentences.
(句子会逐渐变长:两句”短”、三句”中”、两句”长”。)
我们的题按同一套公开结构来生成。那到底有多重?下面是题库里每一句的逐句平均:
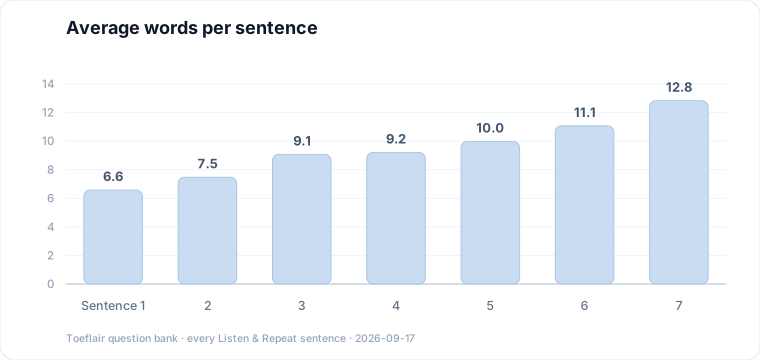
七根柱子,七级台阶。每一句都比前一句长——开头 6.6 词,结尾 12.8 词,中间没有一步是往回走的。而且这是规律不是趋势:除了两组之外,我们所有的题三档均值都严格递增,而且没有一组例外地满足长句重于短句。
下面是完整的一组,从头到尾:
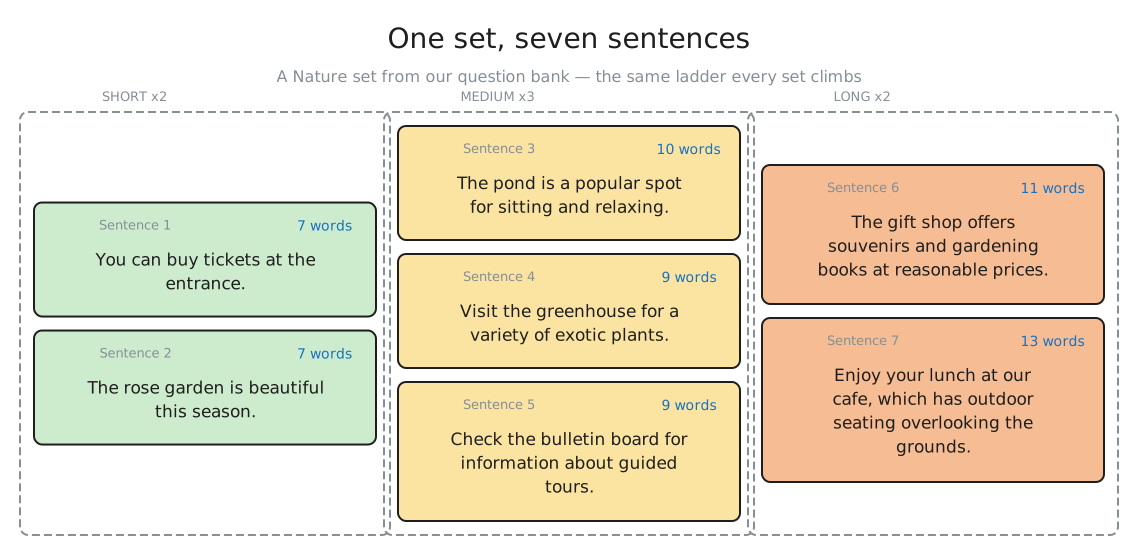
注意那处起伏:第 4 句比第 3 句还短。凑近看每一组都是这样——档与档之间的趋势是可靠的,逐句的递增不是。另外注意最后一句把多出来的词花在哪了:不是多给你几样要记的东西,而是在主句后面挂了一个从句。
记忆负担会变重,你大致知道什么时候变重,你可以据此配速。这部分是所有人都会告诉你的。
让最后两句变难的不是长度
下面这部分没人讲过,而它是更有用的那一半。
如果难度全在长度上,那第 7 句不过就是第 1 句多焊上几个词——更难记,但不会更难解析。题库里不是这样。
现在对同样这些句子量另一件事。不数词数,只看这句是不是复合句——它有没有在主句之外再挂一个从句,而不只是平铺直叙地陈述一件事。
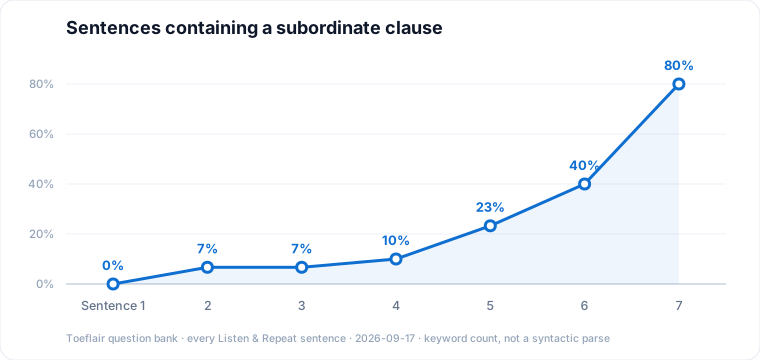
把这条线和上面那组柱子并排看。同样七句话,形状完全不同。柱子是一级一级平稳往上走;这条线前四句几乎贴着地面,然后在最后一句上,近乎垂直地立起来。
两个端点说得最快:第 1 句,我们没有任何一组用了从句;第 7 句,五组里有四组用了。
这里说的复合句,指含有下面十四个从属连词之一——that、which、who、because、although、while、after、before、when、if、since、unless、whose、once。这是关键词计数,不是句法分析:它会把 “before your appointment” 这种介词短语也算进去。尺子是粗糙的,但同一把尺子量过每一句。作为对照,我们也数了单纯的并列连词(and、but、or、so),它们全程是平的。所以姗姗来迟的确实是从句,不是换了个说法的句子长度。
所以这里有两个旋钮,而它们不是一起拧的。长度是一级一级往上走,七句全程都在走;语法则先按兵不动,到最后才猛地拧一把,只拧这一次。长句和复合句不是同一个问题,而在一组 Listen & Repeat 里,它们不是同时到来的。
还有一个细节,因为它会改变你的练法。最后两句里含从句的那些,四分之三以上把从句放在句首——句子先给出一个条件,然后才给出真正的指令。你得先听完整个铺垫,才知道这个铺垫是为什么服务的;也就是说,真正的内容还在路上时,你脑子里已经挂着一个没落地的从句。这才是一组题收尾处真正的负担,它和”多记几个词”是两种不同的能力。
这就给了你一件具体可练的事:到第 6、7 句,别去硬记词,去抓从句的边界——听出条件在哪结束、指令从哪开始,把它当两个语块复述,而不是一条长串。如果你想知道怎么针对某一处失误重练、而不是整组重录,我们另外写过为什么再练十遍也没用。
模拟面试问四道题,顺序几乎是固定的
2026 的另一种口语题是一场模拟面试:虚拟面试官围绕一个日常话题问你四个问题。在我们的题里,这四格干的活明显不同。
第 1 题问的是你——你做过什么,而不是你怎么想。除了一组之外,我们所有的题第 1 题都是经历类问题。下面这道来自一组关于购物的题:
Thank you for speaking with me today. I’d like you to think back to the last time you made a major purchase—either online or in a store. What did you buy? What did you like or dislike about the experience?
(谢谢你今天来聊。我想请你回想一下最近一次大额消费——线上或线下都行。你买了什么?这次体验里你喜欢或不喜欢的地方是什么?)
然后风向就变了。中间两题问你怎么看、为什么。而”权衡”落在最后:要你掂量两面的那些问题,七道里有六道落在最后一格。
把四个题位摞起来看,这条弧线就藏不住了:
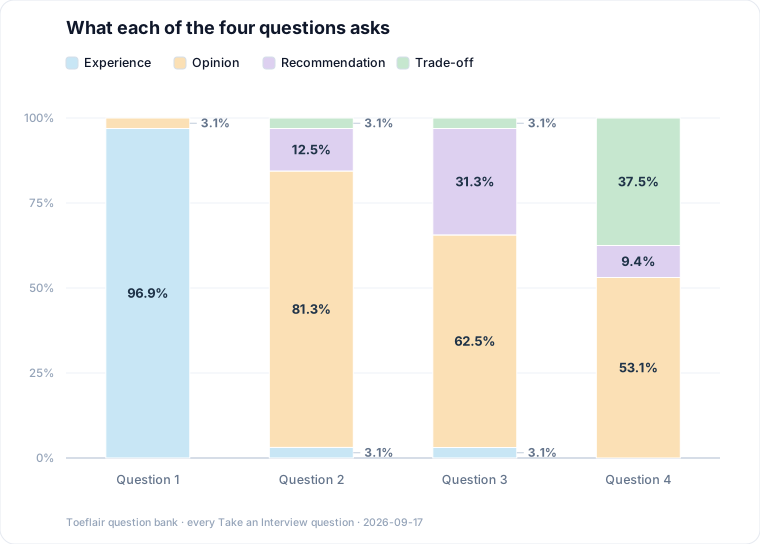
第 1 题只干一件事。从第 2 题起观点类接管,建议类在中间两题悄悄变多——而在前三题里几乎不存在的权衡类,到最后一题吃掉了三分之一还多。
把四个题位合起来看,整体的构成是这样:
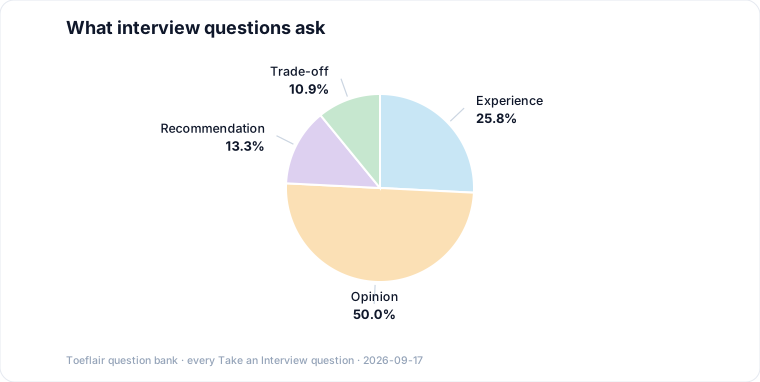
一半是观点题。但顺序比构成更要紧:你从自己的生活开场——那是你能拿到的最好开局的材料——收尾收在一个取舍上,那是最难的。据此分配体力:很多人把最好的状态花在第 1 题,到第 4 题已经没东西了。
而且因为每一问都顺着上一问往下走,只要面试官接住了你刚才说过的某句话,背好的答案当场就失效。这件事我们在为什么背答案在面试题上行不通里详细讲过。
场景覆盖到哪里
场景范围要紧,原因很朴素:不熟悉的场合会白白吃掉你本来不缺的词汇。
两种题型覆盖的地面是刻意错开的。Listen & Repeat 集中在”有人会当面口头给你说明”的场合——我们的题分布在 Campus、Community、Nature、Lifestyle、Health,其中 Campus 一个领域就占了三分之一以上。参观、前台、工作坊、入学导览。
模拟面试要宽得多,因为它需要你对话题有得可说:覆盖十一个领域,以 Lifestyle、Technology、Education 领头,其余是 Community、Culture、Health、Relationships、Work、Travel、Psychology、Financial。
所以两边的准备方式也不同。Listen & Repeat 上,划算的是熟悉”公共场合说明”这一类语域。面试上,划算的是对普通生活有话可说——这件事与其说是背词表,不如说是能不能用英语当场拿出观点。
这些数字该怎么用
上面的数据能直接推出三件事:
- 预判这条阶梯,把注意力花在它的上半段。 第 1、2 句是热身。你用它们找节奏没问题——只要知道吃力的部分从第 6 句开始。
- 第 6、7 句,听结构而不是听词。 一半以上含从属结构,其中四分之三把它前置。抓住边界,分两个语块复述。
- 面试要为第 4 题留体力。 开在自己的经历上,收在一个取舍上。难的那道在最后。
这些都不需要一份题目清单——这恰恰是重点:能迁移的是结构,不是内容。
如果你想亲自感受这条阶梯而不只是读它,我们的 Listen & Repeat 练习会放一整组,并对每一句单独打分,你能看清七句里你的准确度从哪一句开始掉。模拟面试练习则会带着追问走完四问的弧线。两者都可以免费试,如果你好奇底下的分是怎么打出来的,我们拆过 AI 怎么给托福口语打分。
写作侧的逻辑一样,回答的却是另一个问题。我们用同一套测量跑了 Write an Email 题库:托福邮件题到底在要求你做什么那篇里,每道题都恰好列出三条必答要求,而真正的请求几乎总是落在第三条。
本文数字取自 Toeflair 题库中每一句 Listen & Repeat 句子与每一道模拟面试题,取数日期 2026-09-17。我们的题按该题型的三档长度结构、结合不同场景生成;上面按档位做的比较描述的是我们自己这份题库。